Migration vers le cloud : la méthode qui évite les échecs
Publié le · Mis à jour le
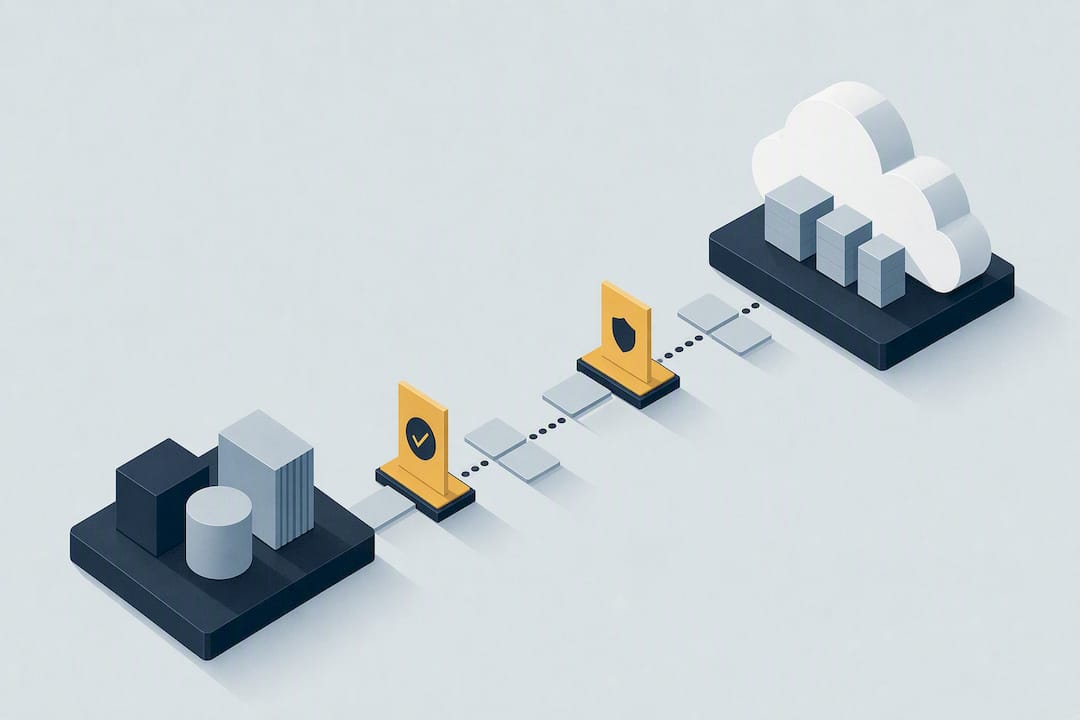
Une migration vers le cloud réussie repose d’abord sur trois piliers : une landing zone testée avant tout transfert, une cartographie complète des dépendances applicatives, et un plan d’exécution par vagues plutôt qu’un basculement massif. Une solution comme Cloud OS peut convenir aux PME qui cherchent à combiner souveraineté des données et accès à du calcul intensif sans gérer d’infrastructure. Le résultat attendu n’est pas la vitesse, mais la réduction du risque opérationnel et une exploitation cloud stable dès le premier jour.
En bref:
- La migration vers le cloud doit commencer par une cartographie précise des dépendances et une mise en place de landing zones testées pour réduire les risques opérationnels.
- Le choix de la stratégie de migration doit être basé sur une évaluation structurée selon les « 7 R », en tenant compte de la dette technique, complexité et valeur métier.
- La phase de préparation, notamment la conception de la landing zone et la migration des données, est aussi importante que la migration elle-même pour assurer stabilité et conformité.
- La surveillance des coûts, via un tagging rigoureux et un rightsizing post-migration, est essentielle pour éviter les dépassements budgétaires.
- La réussite repose aussi sur une formation en amont des équipes, une communication claire, et des pilotes limités pour valider procédures et architectures avant une migration à grande échelle.
Table des matières
- Qu’est-ce que la migration vers le cloud exactement ?
- Comment choisir la bonne stratégie de migration par application (les 7 R) ?
- Quelles sont les phases d’un programme de migration vers le cloud ?
- Comment construire une landing zone solide et éviter le vendor lock-in ?
- Quelles mesures de sécurité appliquer pendant la migration ?
- Comment migrer et valider les données sans perte ni interruption ?
- Comment maîtriser les coûts avec les bonnes pratiques FinOps ?
- Quelle checklist suivre avant chaque vague de migration ?
- Comment préparer les équipes au changement organisationnel ?
- Quel impact la migration a-t-elle sur les performances ?
- Quelle stratégie de sauvegarde et de reprise après sinistre adopter dans le cloud ?
- Comment gérer les données sensibles et la conformité réglementaire ?
- Comment évaluer l’état actuel de son infrastructure avant de migrer ?
- Perspective : ce que révèle vraiment un projet de migration
- Une infrastructure locale pour les PME qui migrent vers le cloud
- Lectures et ressources recommandées
- Sources
- Questions fréquentes
Qu’est-ce que la migration vers le cloud exactement ?
La migration vers le cloud consiste à déplacer des applications, des données et des charges de travail d’une infrastructure locale (ou d’un autre fournisseur) vers un environnement cloud public, privé ou hybride. Elle touche trois catégories d’actifs distinctes : les applications métier elles-mêmes, les bases de données et fichiers qui les alimentent, et l’infrastructure sous-jacente (serveurs, réseau, stockage) qui doit être reconstruite ou adaptée dans le nouvel environnement.
Le bénéfice le plus cité reste financier : basculer d’un modèle d’investissement en capital (achat de serveurs, contrats d’entretien pluriannuels) vers des dépenses opérationnelles ajustées à l’usage réel. Mais ce n’est pas le seul gain. Une infrastructure cloud bien conçue apporte une scalabilité que le matériel physique ne permet pas, un accès direct à des services managés (bases de données, calcul GPU, outils d’IA) sans les déployer soi-même, et une meilleure résilience grâce à la réplication multi-zones.
Les risques, eux, sont trop souvent sous-estimés en phase de vente commerciale :
- Dérive des coûts : sans gouvernance, les factures cloud grimpent vite, notamment via des ressources oubliées en environnement non-prod.
- Dépendance au fournisseur (vendor lock-in) : des formats de données propriétaires ou une architecture trop spécifique à un fournisseur rendent toute sortie coûteuse.
- Conformité réglementaire : la localisation des données, le chiffrement et les obligations sectorielles doivent être vérifiés avant, pas après, la migration.
- Latence et performance : certaines applications critiques peuvent souffrir d’un déplacement mal planifié si la proximité réseau n’est pas prise en compte.
Ces risques ne sont pas des raisons de renoncer à la migration. Ce sont des points de vigilance à documenter dans le plan de projet, avec un propriétaire clairement identifié pour chacun.
Comment choisir la bonne stratégie de migration par application (les 7 R) ?
Toutes les applications ne méritent pas le même traitement. Le cadre des « 7 R » structure la décision application par application :
- Rehost (« lift and shift ») : déplacer l’application telle quelle vers le cloud, sans modification de code. Rapide, mais ne capture pas les bénéfices natifs du cloud.
- Replatform : ajuster légèrement l’architecture (par exemple migrer vers une base de données managée) sans réécrire l’application en profondeur.
- Refactor (ou re-architecture) : reconstruire l’application pour exploiter pleinement les services cloud natifs, souvent vers une architecture en microservices.
- Repurchase : abandonner l’application existante au profit d’une solution SaaS équivalente.
- Retire : constater que l’application n’est plus utilisée et l’éliminer purement et simplement.
- Retain : garder l’application sur site, temporairement ou durablement, pour des raisons réglementaires ou techniques.
- Relocate : déplacer une charge de travail virtualisée d’un centre de données vers le cloud sans changer son architecture technique.
Le choix entre ces sept options ne devrait jamais être arbitraire. Un cadre d’évaluation structuré comme le CMRAF propose d’évaluer chaque application selon cinq dimensions : la dette technique accumulée, la complexité des dépendances avec d’autres systèmes, les exigences de continuité de service, la capacité réelle de l’équipe à mener une réécriture, et la valeur métier générée par l’application.
Cette grille évite un piège classique : refactoriser une application peu stratégique simplement parce que l’équipe technique trouve l’exercice intéressant, pendant qu’une application critique reste en rehost faute de temps.
En pratique, la majorité des portefeuilles applicatifs se répartissent ainsi : une poignée de systèmes historiques à faible valeur ajoutée finissent en retire, le gros du volume part en rehost ou replatform pour aller vite, et seules les applications à fort impact métier justifient un refactor complet. Documentez cette répartition dans un tableau de décision avant de lancer la première vague : c’est ce document qui sert ensuite de référence quand les délais se resserrent et que les arbitrages doivent être rapides.
Quelles sont les phases d’un programme de migration vers le cloud ?
Un programme de migration se découpe en six phases opérationnelles, chacune avec ses livrables et ses points de contrôle. Sauter une étape, ou la traiter superficiellement, est la cause la plus fréquente de dérapage.
Découverte (discovery). Cette phase produit un inventaire exhaustif des applications, un plan de dépendances entre systèmes, et une base de référence des performances actuelles (temps de réponse, charge, coûts). Sans cette cartographie, impossible de savoir quelle application dépend de quelle base de données, ni quel service tiers sera impacté par un changement d’adresse IP.
Décision. À partir de l’inventaire, l’équipe construit un dossier de justification (business case) chiffré et priorise les applications en vagues de migration. Les vagues regroupent généralement des systèmes aux dépendances proches, pour limiter les interactions entre environnements migrés et non migrés.
Conception. C’est ici que se construit la landing zone : la fondation réseau, identité et sécurité sur laquelle tout le reste reposera. Les garde-fous (guardrails) de gouvernance et les scripts d’infrastructure en tant que code (IaC) sont écrits et testés à ce stade, pas après.
Migration (move). Un pilote sur deux ou trois applications sert de test grandeur nature avant d’escalader. Ce pilote valide la réplication des données, les scripts d’automatisation et les procédures de rollback avant que le vrai volume ne soit engagé.
Bascule (cutover). Le passage en production suit une décision go/no-go formelle, avec un plan de retour arrière (rollback runbook) documenté et testé, pas rédigé à la hâte le jour J.
Exploitation (operate). Une fois la charge de travail stabilisée, l’équipe ajuste le dimensionnement des ressources (rightsizing) et établit une propriété claire (day-2 ownership) : qui surveille, qui optimise, qui répond aux incidents.
Un point souvent négligé : la phase de préparation (mobilisation et landing zone) prend fréquemment plus de temps calendaire que la migration technique elle-même. Le guide de migration à grande échelle d’AWS souligne que cette phase de mobilisation est critique : elle sert à bâtir une fondation sécurisée et à automatiser les opérations avant tout transfert massif. Les organisations qui sous-estiment ce temps de préparation se retrouvent à migrer vers une fondation bancale, ce qui coûte bien plus cher à corriger après coup.
Points de vigilance par phase :
- Ne jamais démarrer la conception avant que l’inventaire de découverte soit validé par les équipes métier concernées.
- Toujours tester le plan de rollback avant la première vague réelle, pas seulement en théorie.
- Documenter les critères de go/no-go du cutover à l’avance, pour éviter les décisions prises sous pression le jour du basculement.
Comment construire une landing zone solide et éviter le vendor lock-in ?
La landing zone est la fondation technique sur laquelle repose toute la migration. Elle regroupe la structure des comptes ou projets cloud, l’architecture réseau, la gestion des identités et des accès (IAM), l’observabilité (journaux, métriques, alertes) et une politique de marquage (tagging) systématique des ressources.
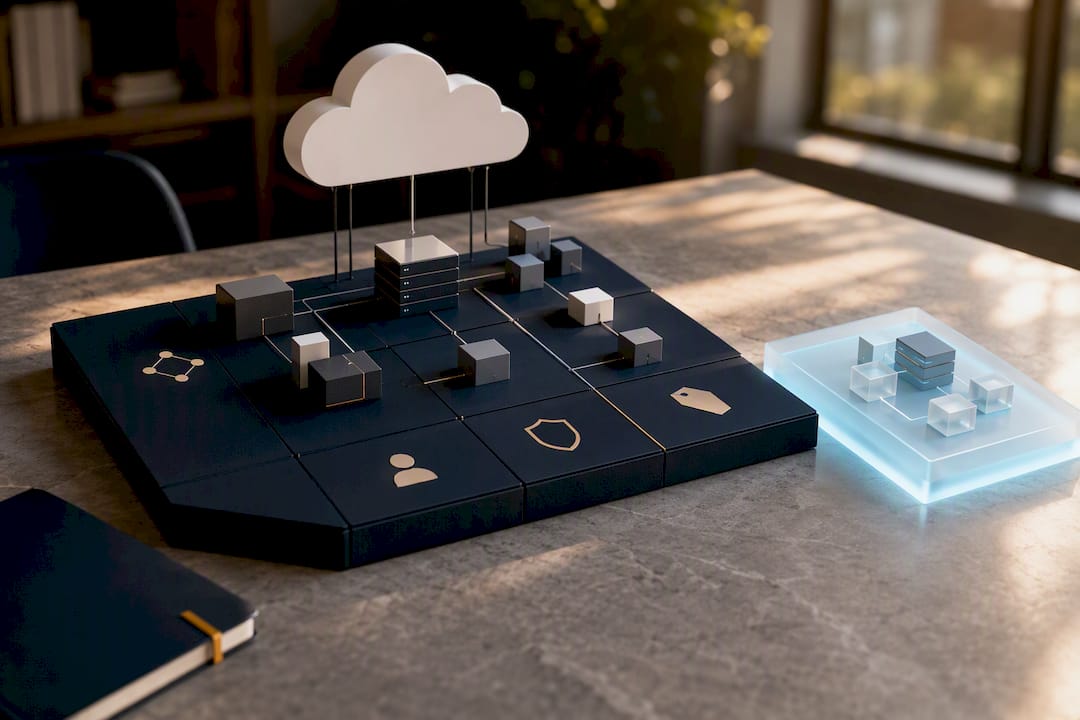
Construire cette fondation en infrastructure as code, plutôt qu’à la main via une console web, change la donne sur la durée : chaque composant devient reproductible, versionné et testable. Une pratique recommandée consiste à valider la landing zone en environnement de test (preview IaC) avant la première vague de production, ce qui réduit sensiblement le coût des corrections ultérieures : reprendre une architecture réseau après que cinquante applications s’y sont raccordées coûte infiniment plus cher que de la corriger avant la première connexion.
Le principe du Design to Exit complète cette fondation. Il s’agit de concevoir l’architecture cloud dès le départ pour qu’une sortie future, partielle ou totale, reste possible sans réécriture complète. Concrètement, cela veut dire privilégier des formats de données portables (Parquet, CSV, objets standards plutôt que des formats propriétaires), documenter précisément les flux réseau et les règles d’accès, et utiliser des outils d’infrastructure as code qui restent, autant que possible, indépendants d’un fournisseur unique. Selon les retours d’expérience compilés par SFEIR, cette discipline architecturale s’avère souvent plus efficace pour limiter le verrouillage fournisseur qu’une stratégie multi-cloud systématique, qui ajoute surtout de la complexité opérationnelle sans garantir la portabilité.
Conseil de pro : Documentez vos flux réseau et vos règles d’accès dès la conception de la landing zone, pas au moment où vous envisagez de partir. Un schéma d’architecture à jour vaut mille heures de rétro-ingénierie le jour où vous négociez avec un nouveau fournisseur.
Quelles mesures de sécurité appliquer pendant la migration ?
Le modèle de responsabilité partagée change la donne dès le premier jour : le fournisseur cloud sécurise l’infrastructure physique et la couche de virtualisation, mais la configuration des accès, le chiffrement des données et la gestion des identités restent sous votre responsabilité. Beaucoup d’incidents de sécurité en environnement cloud proviennent d’une mauvaise compréhension de cette frontière, pas d’une faille chez le fournisseur.
Trois chantiers doivent être traités en parallèle de la migration technique, jamais après :
- Gestion des identités et des accès (IAM) : appliquer le principe du moindre privilège dès la landing zone, avec des rôles distincts par fonction plutôt que des comptes administrateurs partagés.
- Chiffrement et prévention de la perte de données (DLP) : chiffrer les données au repos et en transit, et classifier les données sensibles avant leur transfert, pas après.
- Architecture zero trust : vérifier chaque accès, interne comme externe, plutôt que de faire confiance par défaut à tout ce qui se trouve à l’intérieur du réseau migré.
La documentation d’audit mérite une attention particulière, souvent négligée dans l’urgence du calendrier. Les journaux de configuration, les preuves de chiffrement et les registres d’accès doivent être conservés dès la phase de conception, car reconstituer cette documentation a posteriori pour un audit de conformité est un exercice long et frustrant. Les conditions d’utilisation et la politique de confidentialité d’un fournisseur donnent une bonne indication du niveau de rigueur attendu sur ces sujets, et méritent d’être lues avant la signature, pas après un incident.
Comment migrer et valider les données sans perte ni interruption ?
La migration des données est souvent le maillon le plus fragile du projet, parce qu’elle touche directement à l’intégrité métier.
- Transfert en masse hors ligne (bulk offline) : adapté aux volumes de données qui peuvent tolérer une fenêtre d’indisponibilité, souvent la nuit ou le week-end.
- Réplication continue : les données sont synchronisées en temps réel entre l’environnement source et la cible, ce qui permet une bascule quasi instantanée mais demande une infrastructure de réplication robuste.
- Bascule progressive : une partie du trafic ou des utilisateurs migre en premier, ce qui permet de valider le comportement réel avant un basculement complet.
Avant chaque vague de migration, la découverte des dépendances doit être relancée, pas seulement effectuée une fois en début de projet. Une dépendance manquée entre deux systèmes reste la cause la plus fréquente d’échec au moment du cutover, selon la checklist de migration cloud de Qovery : une application qui semblait autonome révèle parfois, au dernier moment, un appel à une base de données restée sur site.
La validation technique suit un protocole en plusieurs étapes : vérification de l’intégrité des données (comparaison de sommes de contrôle, comptage d’enregistrements), tests de performance en conditions réelles, tests d’acceptation utilisateur (UAT) menés par les équipes métier elles-mêmes, et surveillance renforcée pendant toute la fenêtre de cutover.
Le plan de retour arrière (rollback) n’est pas une formalité administrative. Piloter cette procédure sur deux ou trois applications avant de l’appliquer à l’ensemble du portefeuille permet de valider concrètement la réplication des données et les scripts de rollback avant d’escalader à plus grande échelle.
Comment maîtriser les coûts avec les bonnes pratiques FinOps ?
La gestion des coûts cloud arrive systématiquement en tête des préoccupations des directions informatiques, et la migration est le moment où les mauvaises habitudes s’installent ou se corrigent. Quatre causes prédictibles expliquent la plupart des dépassements budgétaires : l’absence de dimensionnement adapté (rightsizing), des environnements de test ou de développement laissés actifs en permanence, l’absence de marquage systématique des ressources (tagging), et des frais de sortie réseau (egress) non anticipés. Ces quatre points se corrigent avec de la discipline, pas avec des outils supplémentaires.
Les actions concrètes à mettre en place, dans l’ordre :
- Marquer chaque ressource dès sa création, avec un propriétaire identifiable, un centre de coût et un environnement (prod, test, dev) associés.
- Revoir le dimensionnement environ trente jours après le cutover, une fois que la charge réelle est connue, plutôt que de se fier aux estimations de la phase de conception.
- Automatiser l’arrêt des environnements non-prod en dehors des heures ouvrées, ce qui réduit mécaniquement la facture sans effort manuel récurrent.
- Attendre 60 à 90 jours de fonctionnement stable avant de s’engager sur des réservations (instances réservées, plans d’économies) : s’engager trop tôt sur des volumes mal estimés coûte souvent plus cher que de payer à l’usage pendant cette période d’observation.
Une pratique FinOps mature répartit ces responsabilités entre finance, technique et métier, avec des indicateurs suivis régulièrement : coût par application, taux d’utilisation réelle des ressources réservées, écart entre budget prévisionnel et facture réelle. La checklist de migration de Qovery rappelle que ces quatre causes de dépassement sont largement évitables avec un tagging rigoureux et un rightsizing rapide après cutover, deux actions à faible coût mais à fort effet de correction.
Quelle checklist suivre avant chaque vague de migration ?
Une checklist compacte, vérifiée avant chaque vague plutôt qu’une seule fois en début de projet, évite la majorité des incidents évitables :
- Inventaire des applications et cartographie des dépendances validés et à jour.
- Landing zone testée en environnement de préproduction, pas seulement documentée sur papier.
- Marquage systématique des ressources actif dès la première ressource créée.
- Plan de rollback rédigé, testé et connu de toute l’équipe d’astreinte.
- Critères de go/no-go du cutover définis à l’avance, pas improvisés le jour J.
- Fenêtre de surveillance renforcée planifiée pour les premières 48 à 72 heures post-bascule.
Les erreurs qui reviennent le plus souvent d’un projet à l’autre : l’absence de cartographie des dépendances (la cause la plus citée d’échec au cutover selon les retours d’expérience de Qovery), une landing zone construite trop tard ou en parallèle des premières migrations plutôt qu’en amont, l’absence de politique de tagging dès le départ, et un rightsizing repoussé indéfiniment faute de temps.
À retenir : un pilote limité à deux ou trois applications, mené avant toute migration à grande échelle, permet de valider la landing zone, la réplication des données et les procédures de rollback dans des conditions réelles mais à risque contenu, comme le souligne la méthodologie de migration en 12 étapes de Qovery. C’est ce test grandeur nature, pas la documentation théorique, qui révèle les failles du plan avant qu’elles ne coûtent cher.
Un signal qui doit déclencher une pause immédiate : toute dépendance découverte en cours de vague qui n’était pas documentée à l’inventaire initial. Mieux vaut arrêter, cartographier, puis reprendre, que de continuer sur une fondation incomplète.
Comment préparer les équipes au changement organisationnel ?
La migration technique échoue rarement pour des raisons purement techniques. Elle échoue souvent parce que les équipes qui exploitent les systèmes au quotidien n’ont pas été formées, informées ou impliquées à temps.
La formation doit commencer bien avant le cutover, pas le lendemain de la bascule. Les administrateurs système habitués à une infrastructure sur site doivent apprendre de nouveaux outils de supervision, de nouvelles procédures d’astreinte, et parfois un vocabulaire technique entièrement différent. Sans cet accompagnement, le risque n’est pas seulement une baisse de productivité : c’est un rejet silencieux des nouveaux outils, où les équipes reviennent à leurs anciennes habitudes dès que possible.
La communication interne mérite autant d’attention que la formation technique. Les utilisateurs métier doivent savoir à l’avance quand une application sera temporairement indisponible, ce qui change dans leur façon de travailler, et vers qui se tourner en cas de problème. Un canal de support dédié pendant les premières semaines post-migration, avec des réponses rapides, désamorce la plupart des frustrations avant qu’elles ne remontent au niveau de la direction.
Enfin, désignez des relais internes, des personnes déjà à l’aise avec les nouveaux outils, qui peuvent répondre aux questions de leurs collègues au quotidien. Ce relais humain, plus que n’importe quelle documentation, accélère l’adoption réelle des nouveaux environnements.
Quel impact la migration a-t-elle sur les performances ?
Le déplacement d’une application vers le cloud ne garantit pas automatiquement de meilleures performances. Dans certains cas, une application mal réhébergée (rehost pur, sans aucun ajustement) peut même être plus lente que sur son infrastructure d’origine, notamment si la latence réseau entre les composants applicatifs augmente après la migration.
Les gains de performance réels apparaissent surtout quand l’architecture est adaptée aux services cloud natifs : bases de données managées avec mise à l’échelle automatique, répartition de charge géographique, mise en cache distribuée. C’est l’un des arguments en faveur du replatform ou du refactor pour les applications à fort trafic, plutôt qu’un simple rehost qui préserve les limites de l’architecture d’origine.
L’optimisation post-migration se fait en deux temps. D’abord, une phase d’observation d’environ trente jours permet de collecter des données réelles d’utilisation : quelles ressources sont sous-dimensionnées, lesquelles sont surdimensionnées, où se situent les goulots d’étranglement réseau. Ensuite, un cycle d’ajustement continu (rightsizing, mise en cache, révision des architectures les plus sollicitées) devient une activité récurrente, pas un projet ponctuel qu’on referme après le cutover.
Un point souvent oublié : la performance perçue par les utilisateurs finaux dépend aussi de leur propre localisation géographique par rapport aux centres de données choisis. Une infrastructure locale, comme celle proposée par Cloud OS au Québec, réduit cette latence pour les équipes situées dans la même région.
Quelle stratégie de sauvegarde et de reprise après sinistre adopter dans le cloud ?
Le cloud ne remplace pas une stratégie de sauvegarde. Il en change simplement les mécanismes et, bien conçu, il en réduit le coût et la complexité opérationnelle.
Une stratégie de reprise après sinistre robuste repose sur deux indicateurs à définir avant, jamais après, un incident : l’objectif de temps de reprise (combien de temps l’organisation peut tolérer une interruption) et l’objectif de point de reprise (combien de données récentes peuvent être perdues sans conséquence grave). Ces deux chiffres déterminent directement l’architecture de sauvegarde à mettre en place, pas l’inverse.
Trois niveaux de protection se combinent généralement. Des sauvegardes régulières et automatisées, stockées dans une zone géographique distincte de l’environnement de production, protègent contre la perte de données classique. Une réplication multi-zones ou multi-région protège contre la panne d’un centre de données entier. Et des tests de restauration réguliers, effectués en conditions réelles et pas seulement documentés sur papier, garantissent que la sauvegarde fonctionne vraiment le jour où elle est nécessaire.
C’est ce dernier point qui fait le plus souvent défaut : une sauvegarde jamais testée n’est qu’une hypothèse. Planifiez un exercice de restauration complet au moins une fois par trimestre, avec les équipes qui devront réellement l’exécuter en situation de crise, pas uniquement l’équipe qui a conçu la procédure.
Comment gérer les données sensibles et la conformité réglementaire ?
La migration vers le cloud est le moment idéal pour clarifier, ou corriger, la gouvernance des données sensibles. Trop d’organisations découvrent après coup que des données personnelles ou réglementées circulaient sans classification claire dans leurs systèmes d’origine.
La localisation des données reste le premier point de vigilance pour toute organisation soumise à des obligations de résidence des données, qu’il s’agisse du RGPD pour les données concernant des résidents européens ou d’autres cadres réglementaires sectoriels. Avant de migrer, identifiez précisément où chaque catégorie de données sera physiquement stockée, et vérifiez que cette localisation respecte les obligations qui s’appliquent à votre organisation et à vos clients.
Le chiffrement, la pseudonymisation des données personnelles quand c’est possible, et la tenue d’un registre des traitements deviennent des prérequis techniques à intégrer directement dans la conception de la landing zone, pas des ajouts de dernière minute. La documentation des flux de données entre systèmes, déjà nécessaire pour le Design to Exit évoqué plus haut, sert aussi de base à toute analyse d’impact réglementaire.
Un fournisseur cloud qui héberge les données sur une infrastructure locale, comme le fait Cloud OS au Québec, simplifie certains aspects de cette conformité pour les organisations dont les obligations réglementaires exigent une résidence des données dans un territoire précis. Cela ne dispense pas de l’analyse de conformité propre à chaque secteur d’activité, mais cela réduit une variable d’incertitude majeure.
Comment évaluer l’état actuel de son infrastructure avant de migrer ?
Avant toute décision de migration, un audit de l’existant (assessment) s’impose. Cet exercice répond à une question simple mais souvent mal traitée : que possédons-nous réellement, et comment ces éléments interagissent-ils entre eux ?
L’inventaire technique recense chaque application, chaque base de données, chaque dépendance réseau, avec leur niveau d’utilisation réel plutôt que théorique. Des outils de découverte automatisée scannent l’infrastructure existante pour révéler des connexions que la documentation officielle a oubliées, ce qui arrive plus souvent qu’on ne le pense dans des environnements qui ont évolué sur plusieurs années sans mise à jour de la documentation.
L’évaluation de la dette technique complète cet inventaire : quelles applications reposent sur des versions de logiciels obsolètes, quelles architectures ont accumulé des correctifs temporaires jamais résolus définitivement. C’est cette évaluation qui alimente directement le choix de stratégie parmi les 7 R évoqués plus haut, via un cadre comme le CMRAF.
Enfin, l’établissement d’une base de référence de performance (baseline) avant migration donne un point de comparaison objectif après la bascule. Sans cette référence, impossible de savoir si une lenteur perçue après migration est réelle ou simplement une impression liée au changement d’environnement. Documentez les temps de réponse, la charge moyenne et les pics d’utilisation avant de commencer, ce sera votre seul repère fiable ensuite.
Perspective : ce que révèle vraiment un projet de migration
La plupart des guides de migration vendent la vitesse. Le vrai différenciateur, c’est la discipline de préparation : les organisations qui prennent le temps de cartographier leurs dépendances et de tester leur landing zone avant la première vague s’en sortent presque toujours mieux que celles qui migrent vite et corrigent après coup. Ce n’est pas une opinion contrariante, c’est ce que montrent, projet après projet, les retours d’expérience du secteur.
Cloud OS s’inscrit dans cette logique pragmatique pour les PME québécoises : hébergement local, tarification à l’usage, et accès à du calcul intensif sans gestion d’infrastructure. Ce ne sont pas des promesses marketing vagues, ce sont des caractéristiques factuelles du service, documentées sur leur page dédiée aux PME. Il faut cependant rester honnête sur ce qui manque : il n’existe pas, à ce jour, d’évaluations tierces indépendantes largement publiées sur ce service. Les décideurs IT devraient traiter cette absence comme un point à vérifier eux-mêmes, pas comme un obstacle disqualifiant.
— Maxime
Une infrastructure locale pour les PME qui migrent vers le cloud
Pour une PME québécoise qui migre vers le cloud, la question qui revient toujours est la même : où vont réellement mes données, et qui peut y accéder ? Cloud OS répond à cette préoccupation en gardant les traitements sur une infrastructure détenue localement à Québec, avec une tarification qui suit l’usage réel plutôt qu’un engagement fixe et surdimensionné.
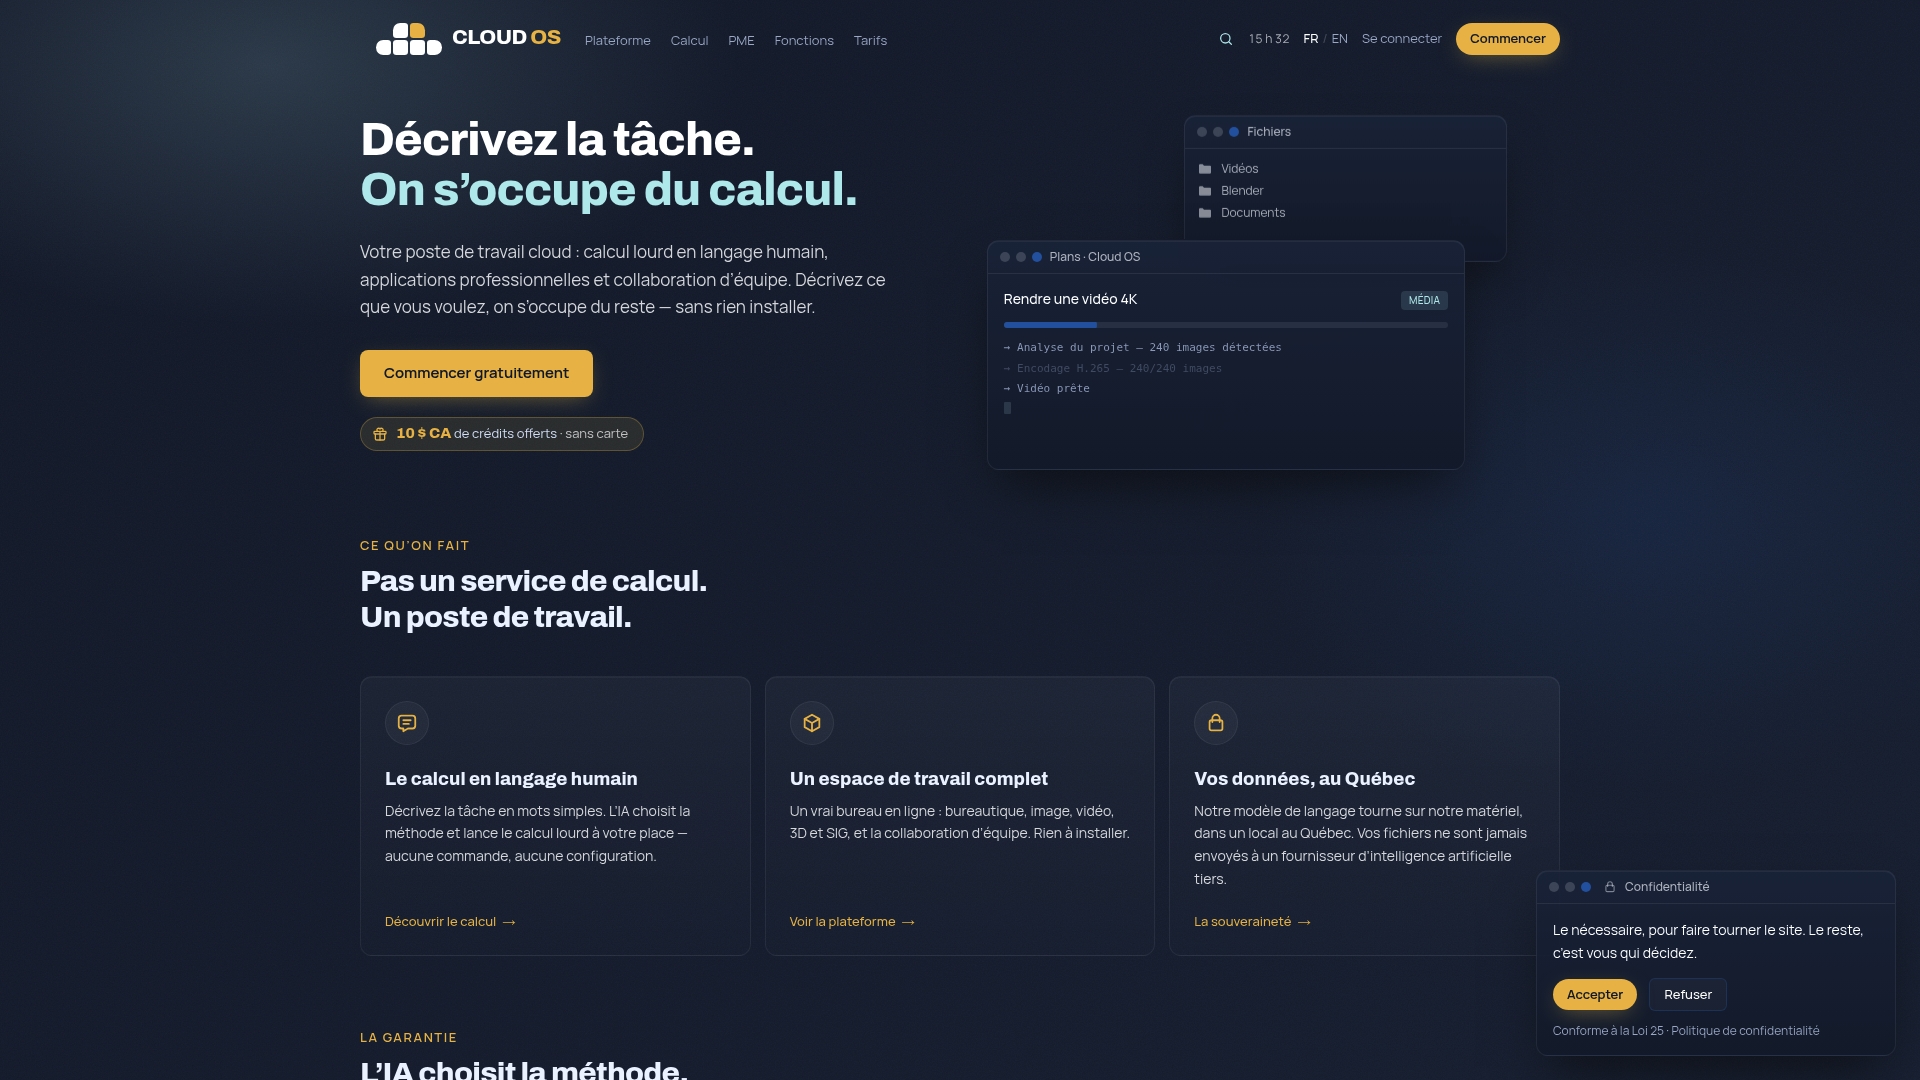
Trois cas d’usage illustrent concrètement cette approche. Un cabinet d’ingénierie qui a besoin de rendu 3D ponctuel n’a plus à investir dans des postes de travail dédiés au GPU : le calcul se fait à la demande, facturé par frame. Une équipe qui traite régulièrement des données géospatiales accède à des outils SIG sans installation locale ni licence lourde à gérer. Et une entreprise qui produit du contenu média peut lancer du montage vidéo ou du traitement d’images directement depuis le navigateur, sans dimensionner de poste de travail spécialisé pour chaque collaborateur.
La tarification suit cette logique de flexibilité avec des plans mensuels adaptés aux différents usages, détaillés sur la page tarifs. Les tâches spécifiques comme le calcul GPU, le rendu 3D, l’extraction web, ou le traitement d’images sont facturées à l’unité, évitant un paiement pour des capacités non utilisées. Pour une PME qui évalue sa prochaine étape de migration, consulter les fonctionnalités disponibles donne une vue concrète de ce qui est accessible sans installation préalable.
Lectures et ressources recommandées
Pour approfondir la méthodologie présentée ici, plusieurs ressources font référence dans le secteur. Le guide de migration à grande échelle d’AWS détaille la phase de mobilisation et la construction d’une landing zone sécurisée. La checklist en 12 étapes de Qovery reste la référence la plus concrète pour structurer un projet phase par phase, avec un accent particulier sur les pièges de coûts. Pour le Design to Exit et les retours d’expérience terrain, l’analyse de SFEIR sur la migration cloud apporte un éclairage pratique. Enfin, pour structurer le choix entre les 7 R, le cadre CMRAF propose une grille d’évaluation multicritère rigoureuse.
Sources
- AWS prescriptive guidance — Large migration guide
- Qovery — The Cloud Migration Checklist I Wish I Had
- SFEIR — Migrer vers le cloud en 2026 : méthodologie et retours d’expérience
Questions fréquentes
Qu’est-ce que la migration vers le cloud ?
La migration vers le cloud consiste à déplacer des applications, des données et des infrastructures depuis un environnement local ou un autre fournisseur vers un environnement cloud public, privé ou hybride. Elle inclut généralement une phase de découverte, la construction d’une landing zone, une exécution par vagues et une phase d’exploitation post-migration.
Comment transférer des fichiers vers le cloud en toute sécurité ?
Le transfert de fichiers doit passer par un canal chiffré, avec une vérification d’intégrité (comparaison de sommes de contrôle) une fois le transfert terminé. Pour des volumes importants, un transfert en masse hors ligne planifié pendant une fenêtre de faible activité limite le risque d’interruption, tandis qu’une réplication continue convient mieux aux données qui changent en permanence.
Quels sont les principaux inconvénients du stockage dans le cloud ?
Trois limites reviennent le plus souvent : la dépendance à une connexion réseau stable pour accéder aux données, le risque de dépendance excessive à un fournisseur si l’architecture n’a pas été pensée pour rester portable, et des coûts qui peuvent grimper sans gouvernance claire du tagging et du dimensionnement des ressources.
Qu’est-ce que le cloud sur un téléphone ou un ordinateur au quotidien ?
Dans un usage quotidien, le cloud désigne l’accès à des applications et à des données stockées sur des serveurs distants plutôt que sur l’appareil lui-même, accessibles via une connexion internet. Un environnement comme Cloud OS applique ce même principe à l’échelle professionnelle : les outils bureautiques, de traitement média ou de calcul restent accessibles sans installation locale.
Combien coûte une migration vers le cloud pour une PME ?
Le coût dépend fortement du volume de données, du nombre d’applications et de la stratégie choisie parmi les 7 R, ce qui rend un chiffre unique peu fiable sans audit préalable. Pour des besoins ponctuels de calcul ou de traitement, les tarifs à l’usage de Cloud OS commencent autour de 0,25 $ CA par tâche, avec des plans mensuels affichés sur la page tarifs.